智能字幕匹配メイリン モデルコレクション メ
在视频内容快速增长的今天,字幕已经不只是画面下方的文字说明,更是连接声音、画面与观众的重要桥梁。智能字幕匹配技术通过语音识别、语义分析和时间轴校准,让字幕能够更准确地对应人物对白与视频情节。以“メイリン モデルコレクション メ”为代表的模型集合,也为多场景字幕处理提供了新的想象空间。
传统字幕制作往往依赖人工听译、切分和校对,不仅耗时较长,还容易出现错字、漏句、时间轴偏移等问题。智能字幕匹配则可以先将音频转换为文本,再结合说话人的语速、停顿和画面节奏,自动调整字幕的出现与消失时间。当视频中存在多人对话、背景噪声或方言口音时,系统还能够借助上下文进行判断,从而提升识别的连贯性。
模型集合的价值在于,它并非只依靠单一算法完成任务,而是根据不同需求调用适合的模型。例如,语音识别模型负责捕捉对白内容,语言模型负责修正语句和标点,翻译模型负责跨语言转换,视觉模型则可以参考人物口型、场景变化与镜头切换。将这些能力整合起来,便能形成更加完整的字幕匹配流程。“メイリン モデルコレクション メ”这一名称虽然带有多语言色彩,却也象征着模型协同与文化交流的可能性。
在实际应用中,智能字幕匹配可服务于影视制作、在线课程、直播平台、会议记录和短视频创作。创作者只需上传视频,系统便能生成初步字幕,并提供时间轴编辑、关键词检索、说话人区分和多语种导出等功能。人工人员不再需要从零开始制作,而是将精力集中在语气润色、专业词汇确认和文化表达调整上。
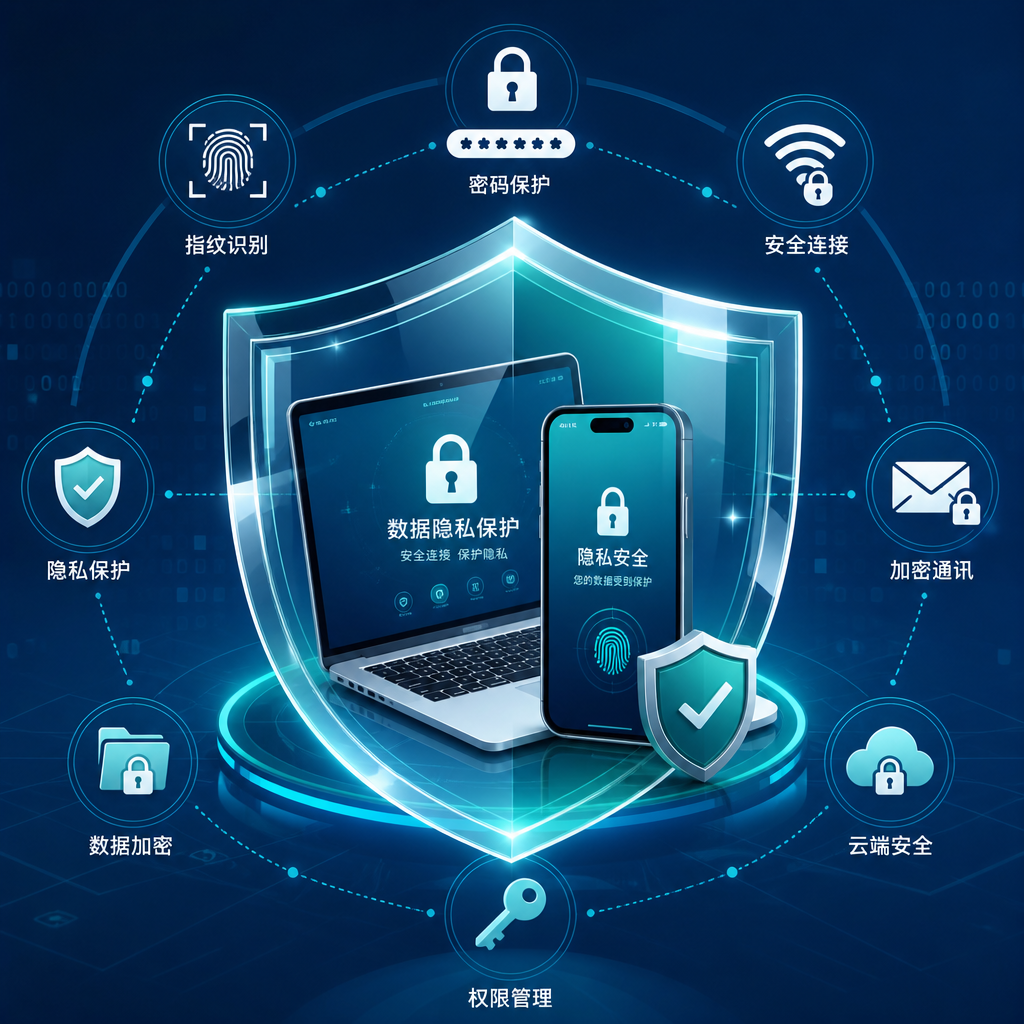
当然,智能技术并不能完全取代人工判断。人名、地名、行业术语以及带有情绪色彩的表达,仍可能受到语境影响。高质量的字幕系统应当保留人工复核入口,并明确标注不确定内容。同时,在处理会议、访谈等材料时,还要重视隐私保护、数据加密和授权管理。
未来,智能字幕匹配将从“听见并转写”逐步发展为“理解并呈现”。借助更强的多模态模型,字幕不仅能够准确跟随声音,还能适应画面节奏、人物情绪与观众习惯。无论是“メイリン モデルコレクション メ”这样的模型集合,还是更成熟的行业方案,其最终目标都是让信息跨越语言与听觉障碍,更自然、更准确地抵达每一位观众。